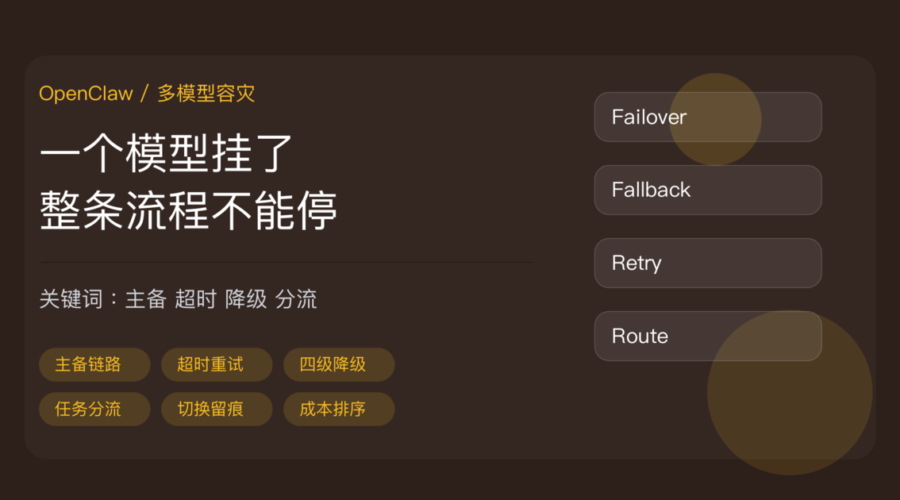
先说个很常见的翻车现场:月末那天,OpenClaw 要跑三百条对账任务。跑到第一百多条,主力模型的接口开始返回限流错误,重试几次还是失败,任务队列卡在那里,一直卡到第二天早上人来看。系统没坏,只是「那个模型今天不太行」,但整条流程一起停了。
这就是多模型容灾要解决的问题。不过得先纠正一个误区:很多人以为多模型容灾就是把几个 API Key 都写进配置里,让程序随机挑一个。那不叫容灾,那叫把不确定性放大——不同模型的能力、价格、格式稳定性都不一样,随机切换等于让输出质量随机波动。
先分清三种「挂」:处理方式完全不同
(1)彻底不可用。接口报错、鉴权失效、服务下线。特征很明确:请求根本发不出去。这种最好处理,直接切备用。
(2)抖动与超时。请求发出去了,但很慢、或者偶发失败。这类最容易被误判:你以为是网络问题,其实是对方在限流。如果直接用「重试」硬扛,很可能把限流变成封禁。排查思路和 AI Agent 工具调用失败怎么排查 完全一致。
(3)静默降质。最危险的一种。接口正常返回,但内容变差了——格式开始跑偏、工具参数错、或者干脆开始编。它不报错、不超时,最后以「结果不对」的形式暴露在交付环节。多模型容灾的设计重点,恰恰应该是第三类。
主备怎么分:等值备份 vs 分级备份
(1)等值备份,也就是同档替换。主备两个模型能力相近、价格相近,互为替代。优点是切换后输出质量几乎不变,回归压力小;缺点是成本不会因为切换而降,而且「两个能力相近的模型」本身不好找——同一代里往往只有一个最适合你的任务。
(2)分级备份,也就是降档兜底。主力用强模型,备用是便宜的小模型。优点是省钱、可用性有保障;缺点是切换后质量一定下降,所以你必须先知道「哪些任务可以忍受降质」。
实际做法通常是两者结合:同档备份保可用,降档兜底保不停。先接第二个供应商的同档模型作为一等备用,再准备一个小模型作为最后兜底。国内可用的模型来源怎么接,前置配置见 OpenClaw 怎么接 DeepSeek 等国产大模型;如果想把私有模型也放进链路,OpenClaw 本地模型怎么接 里有 Ollama 和 LM Studio 的配置方式。
超时与重试:三件事定死
(1)超时阈值按任务类型定,不要全局一个值。摘要类任务十几秒不回就可以放弃,长文档分析两分钟才算异常。用一个超时值套所有任务,要么误杀正常任务,要么把故障等成超时。
(2)重试次数要少,退避要拉开。限流场景下密集重试是最差选择。建议最多重试一两次、间隔指数退避,并且把「重试」和「切换」合并成一个决策——重试两次还不行就直接切备用,不要在同一个模型上磨。
(3)写动作不能无脑重试。如果这一步是提交订单、发送邮件、写入数据库,重试可能造成重复执行。必须让这类动作幂等,或者在重试前先确认上一次的结果。工具怎么设计才能重试安全,AI Agent 工具怎么设计才好用 里讲得很清楚。
降级阶梯:四级,越往下越保守
把降级设计成有台阶的,而不是「能用/不能用」二选一:
一级:换供应商同档模型。质量基本不变,用户几乎无感,默认走这一级。
二级:换成本更低的模型。质量下降,但任务能继续。适合摘要、分类、格式化这类容错度高的任务。
三级:只做只读与摘要,暂停写动作。这一步很关键——模型越不可靠,越不应该让它执行有副作用的动作。降级时把「写」的能力收掉,只保留读和总结,是最划算的一刀。
四级:停下并转人工。当所有来源都不可用、或者任务属于不允许降质的关键类,就应该停下来通知人,而不是硬撑着给出一个错的答案。失败之后什么时候升级、通知谁,规则见 AI Agent 失败升级规则怎么定。
按任务分流:先给任务分级,再谈路由
(1)可降质:摘要、分类、打标签、格式转换、初稿。可以用便宜模型,可以降级,甚至可以延后到闲时跑。
(2)不可降质:对外交付物、财务与合同相关结论、客户可见内容。必须用指定档位的模型,不允许静默降档——不行就停。
(3)必须人工确认:付款、外发、删除、权限变更。这类任务始终走人工确认队列,模型只是准备材料的一方。
把任务分成这三档之后,路由规则就自然出来了:可降质的任务优先省钱和保可用,不可降质的任务优先保质量,必须确认的任务优先保安全边界。异常怎么划分「可重试、需确认、必须熔断」,可以对照 AI Agent 异常分级怎么做;「先停住再谈重试」的做法,OpenClaw 熔断与暂停机制怎么做 讲得更细。成本的完整算法,可以参考 AI Agent 成本怎么算、怎么省。
切换了怎么知道:留痕、告警、回归
容灾做得再好,如果切换是悄悄发生的,你会遇到更难查的问题:同一批任务这周的结果和上周不一样,但没人知道中途换过模型。
(1)每次切换都记一条:时间、原模型、新模型、触发原因(超时/报错/限流)、影响的任务数。
(2)告警要分级。偶发一次切换不必打扰人;一小时内切换超过阈值、或者关键任务被降级,必须告警。降噪的做法和 OpenClaw 日志怎么看、报错怎么排查 里的思路一致。
(3)切换后跑回归。尤其是降档之后,要拿一批固定样本对比新旧输出,确认差异在可接受范围内再继续跑。回放验证怎么做,OpenClaw 模型版本管理 和 OpenClaw 回放对照怎么做 讲的是同一套方法,区别只在于触发原因是「主动升级」还是「被动降级」。
落地五步
(1)先把模型调用收敛成一个统一入口。所有任务不直接调模型,而是经过一层「模型网关」,由它决定用哪个、能不能降级。没有这一步,容灾无从谈起。
(2)配置里给每个模型写清楚四件事:能力档位(强/中/弱)、单价、超时阈值、可承接的任务档位。
(3)给任务打标签。每条任务在创建时就带上「可降质/不可降质/必须人工」,路由规则读这个标签。
(4)先只开一级降级,跑一周再加二级。阶梯一次加满,你根本不知道是哪一级在起作用。
(5)做一次演练。主动把主力模型的 Key 改错,看系统是不是按预期切到备用、有没有告警、任务有没有继续。不演练的容灾等于没有。
三个坑
坑一:把「多写几个 Key」当容灾。没有统一入口、没有降级规则、没有留痕,只是让失败变得更随机。
坑二:让降级静默发生。用户拿到一份质量下降的结果,却以为和以前一样,这是最伤信任的一种。降级必须可见——至少要在结果里标注,或者在任务记录里留痕。
坑三:只考虑模型,不考虑模型之外的依赖。模型能切,但工具、数据库、网络、凭证也可能挂。完整的容灾要连「依赖清单」一起列:哪些能切、哪些只能停。更全面的失败面拆解,可以对比 AI Agent 死循环怎么治 里的熔断思路,以及 AI Agent 上下文管理 里讲的「故障时怎么保留有效上下文」。
优缺点与适合人群
好处:单个供应商抖动不再等于业务停摆;成本可以按任务分档控制;切换有记录,结果差异能解释;对外的可用性承诺敢写进 SLA。
代价:多了一套要维护的路由与降级逻辑;多模型意味着多套提示词的差异要调(不同模型对格式和指令的敏感度不一样);降级带来的质量波动需要靠回归和留痕去管理,这部分是持续的运维成本。
适合人群:自动化流程已经跑在生产上、对「不能停」有硬要求的团队;用量大、对成本敏感的团队;多客户、需要按客户分级服务质量的团队。不适合:还在试跑阶段、每天只跑几条任务的小规模使用——这时候先把单模型跑稳、把日志和失败处理做好,性价比更高。
总结
OpenClaw 多模型容灾,一条主线:先把模型调用收敛成统一入口;再分清三种「挂」——不可用、超时抖动、静默降质,把设计重点放在不报错的那一种;主备用「同档保可用 + 降档保不停」的组合;超时按任务定、重试要少且退避、写动作用幂等;降级做成四级台阶,并在降级时把写动作收掉;任务按可降质、不可降质、必须人工三档分流;每次切换都留痕、按阈值告警、必要时跑回归。一句心法:容灾的目标不是「永远用最好的模型」,而是「任何一个模型不行的时候,你都知道系统会退到哪一步、退完之后结果还能不能用」。