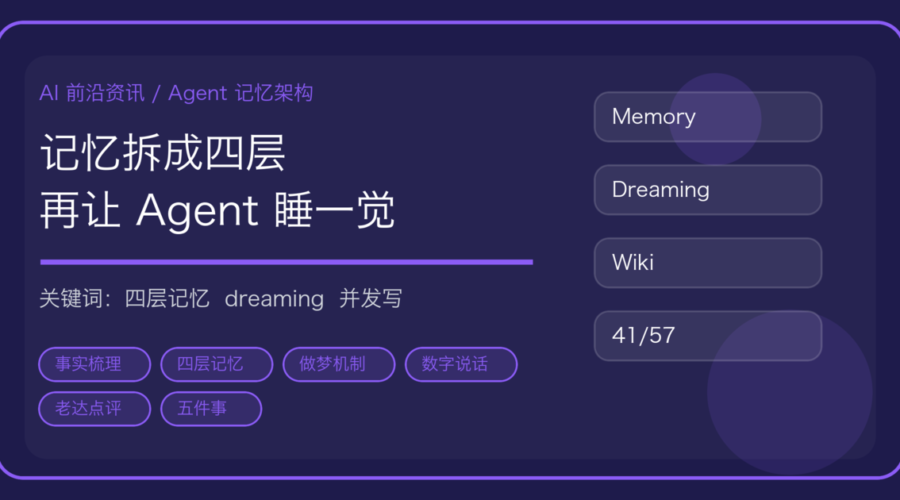
11 月 6 日,Anthropic 发了一篇研究博客《The components of agent memory》,把 Claude 跨会话记忆的设计拆成了四层,还带回一个听着像玩笑的词:做梦(dreaming)。
这不是产品发布。没有新模型、没有新 API、没有价格变化,全部数字来自他们自己的评测。但它比很多发布会更值得看,因为它第一次把「Agent 记忆」这个被讲烂了的话题,变成了一张可以照着搭的结构图,还配了失败案例。
一、事实梳理:四层记忆,加一个离线动作
Anthropic 先把定义收窄了。他们说的「Agent 记忆」,指的是 Claude 从经验中获得、跨会话保留下来、之后能读到的那部分知识。这个定义刻意排除了三样东西:训练时写进权重的参数、单次对话内的上下文学习、以及上下文快满时用摘要替换旧轮次的压缩(compaction)。换句话说,压缩不是记忆,它只是让你能继续干活。
然后是四层,从下往上:
会话日志(transcripts):可搜索的事件日志,记录 Claude 做了什么、工具返回了什么,是整套记忆的事实底座。
记忆笔记(memory notes):Claude 自己写下的要点,比如一条被验证过的规则、一个踩过的坑。
记忆表征(memory representations):由日志和笔记算出来的结构化产物,典型形态是 wiki——一个由 Claude 自己编写、页面之间互相链接的知识库。
注入上下文(injected context):每次新会话开始时预加载进去的那一小块,很小,按需再检索。
层与层之间不是单向往上流的,相邻层双向。而贯穿四层的动作就是 dreaming:在会话之间的空闲时间,Agent 回读原始日志,纠正写错的笔记,把零散内容提升成 wiki 页面,再把值得预加载的东西挑出来。这个思路不是他们原创,来自 Letta 与 UC Berkeley 提出的「睡眠时计算」,Anthropic 借的是人脑睡眠期海马体回放的那套分工。
二、dreaming 到底在修什么
文章里最有说服力的例子是一局《宝可梦 红》。Claude 在笔记里写错了:把宝可梦中心记成了月见山的东侧。走出建筑之后它宣布「月见山已经搞定」,然后从单向悬崖上掉了三次,最后写下「我还是停下来吧,省得一直原地打转」,转头走回了尼比市。
一次 dreaming 跑完,系统把这条笔记和会话日志对照,发现错了,改写。带着修正后的笔记,Claude 直接走回月见山,到达了华蓝市。
第二个例子是 35 万份内部文档、约 4.2 亿 token 的语料,用 128 次 dreaming 让 Agent 反复建 wiki、合并重复页面、拿原始材料核对说法。结果是在一个法律基准里,一份原本只覆盖 57 个事实中 41 个(72%)的摘要,改成「每份合同单独一页、逐字引用条款」之后,满足了全部评审标准。
三、数字说话:记忆的胜负不在容量
最能说明问题的是两个对比。
第一个是同一道题的两种成绩。在 Continual Learning Bench 1.0 的数据库检索任务里,每次提问都从全新会话开始,唯一跨会话带过去的只有一个可读写的记忆目录。Sonnet 4.6 用了记忆后从 0.330 涨到 0.364,几乎没动;Opus 5 从 0.564 涨到 0.828。差别不在有没有记忆,在于会不会「闭环」:Opus 5 的笔记里,多数条目写的是规则、这条规则怎么被验证过、之前答错过什么、以及路上有哪些陷阱。Sonnet 4.6 的目录里是一堆没验证过的猜测。
第二个是宝可梦里的文件数。Sonnet 3.7 建了 413 个笔记文件、225 个文件夹,到一万步左右记忆已经接近 98 万字符,然后开始建第四个「master」文件夹,接下来 17 步里建了 6 个文件、删了 9 个,一步游戏都没打——最后只拿到 1 枚徽章。Fable 5 写了 9 个文件、两个文件夹,外加一个 global.md 当控制面板,只记「屏幕上读不到的东西」:策略、计划、验证过的规则。它拿到 4 枚徽章并通关。中间有一条笔记是这样写的:连续三个球没抓到鲤鱼王之后,改节奏,在菜单步骤之间多按几次等待,然后就抓到了。
还有两个工程数字特别值得抄进设计文档。一是并发写同一个共享记忆文件会丢数据:57 个事实只有 41 个活下来;改成每个 Agent 一份独立文件、由汇总方合并,是 57/57 全保。二是注入上下文必须小,他们拿 Claude Code 举例,索引上限是 200 行、25KB。
四、影响分析:瓶颈从「存多少」移到「整不整」
第一,记忆开始有独立的工程工序。过去做记忆就是「把历史塞进上下文」,现在多了一道离线整理。这道工序不便宜——128 次 dreaming 意味着 128 遍回读和重写——但它解决的是压缩解决不了的问题:压缩是有损的、单向的, dreaming 是可纠正的。
第二,「记什么」变成可评估的问题。Anthropic 的定义把记忆说成一种预测:写下一条规则,等于预测这个模式以后还会用到。既然是预测,就能算准不准。这跟评测的思路接上了——记忆质量可以像模型能力一样被跑分,而不是靠感觉。
第三,多 Agent 共享记忆是个陷阱。41/57 这个数字说明,共享文件在并发写下的丢数据不是偶发 bug,是结构问题。多 Agent 场景里更稳的形态是「每人一份、有唯一写者汇总」,这跟多 Agent 协作里讨论的写入冲突是同一件事。
第四,注入预算决定架构。200 行、25KB 的上限很硬。它逼着你把「每次都要知道的」和「需要时再查的」分开:索引进上下文,内容靠检索。反过来做,就是每轮都在为一个用不上的历史付缓存和延迟的钱。
第五,与「会话单位」那条线正面对上了。Super-agent 的存算分离在解决多任务隔离,Anthropic 这套在解决单 Agent 的长期记忆。两条路都在把状态从「窗口里」搬到「窗口外」,只是搬家方式不同。
五、老达点评
一、最值钱的不是 dreaming 这个词,是「记忆是预测」这个定义。定义一变,问题就从「怎么把历史存下来」变成「存下来的东西后来用上了没有」。后者可以量化,前者只能争论。
二、413 个文件对 9 个文件,是我这半年看到最能劝人「少写点」的证据。我们给 Agent 写提示词、写规则、写 SOP,路径依赖跟 Sonnet 3.7 一模一样:觉得多写一条就多一层保险,实际是多一层干扰,最后连游戏都不打了,光在整理文件夹。
三、「告诉它为什么,不要告诉它怎么做」这条,跟工程直觉是反的,但在记忆上成立。Anthropic 说只加一句「有一个记忆文件夹可用」,Opus 4.7 和 Opus 5 就自己用得很好;加上「只记录失败」这条规则,两个模型的改进大部分消失了。原因不难想:规则是死的,场景是活的。这条对写 Skill、写 AGENTS.md 的人同样适用。
四、41/57 这个并发写数字,比任何架构图都该进设计文档。很多团队做共享记忆的第一版就是「大家都往一个 memory.md 里写」,然后丢数据丢得毫无察觉——因为丢的是事实,不是报错。
五、自评数字要打折,方向可信。全部结果来自 Anthropic 自己的评测,没有第三方复现。但「小记忆 + 会整理」优于「大记忆 + 不整理」这个方向,跟他们自家的产品行为是一致的:Claude Code 的索引就是有硬上限的。
六、还看不清的五件事
一是记忆的权限边界。一个 Agent 跨会话记住的东西,哪些能被另一个 Agent 读?文章讲的是单 Agent,多租户场景下的隔离没提。
二是错误规则怎么回滚。dreaming 能纠错,但如果一条错规则已经被用来做了几十个决策,回滚是改笔记就够了,还是要把相关产出一起审?
三是成本。128 次离线整理对应的算力花销文章没给。对个人用户无所谓,对企业是能不能天天跑的问题。
四是合规。记忆里存了客户数据、合同条款,删除请求怎么落到 wiki 页面上?这块比日志删除难得多,因为表征是衍生数据。
五是跨模型迁移。这套四层结构是文件形态的,理论上换模型还在。但笔记是给 Claude 写的,换一个模型读得懂吗?这决定了记忆到底属于用户还是属于厂商。
七、总结
如果你只从这篇里拿一件事,就拿这个顺序:先把日志留全,再让 Agent 自己写笔记,然后定期离线整理,最后只把索引注入上下文。四步里最容易省的是第三步,而它恰好是决定成败的那一步。想先看记忆为什么会坏,可以看记忆污染治理那篇;想直接动手,就从一个有明确对错的任务开始,让 Agent 记「规则 + 怎么验证的」,跑两周再看它有没有变聪明。