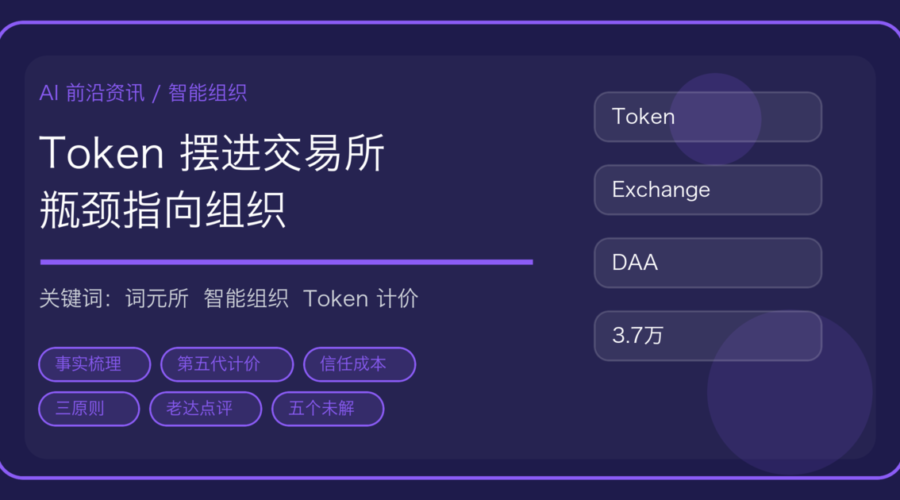
11 月 12 日,百度世界 2026 在北京办,主题叫「下一幕 智能组织」。李彦宏给了一个类比:2016 年百度世界说的是「AI is the new electricity」,十年后他发现电换了,厂房没换——「换一台 AI 新电机只是起点,重新设计新厂房才是分水岭」。同场真正值得记的不是这句比喻,是一个叫「词元所」的东西:把大模型的 Token 摆进交易所。
这两件事看着不搭,其实是一条线上的两头:一头是「AI 花出去的钱为什么没变成利润」,一头是「买 Token 这件事凭什么不可信」。本篇把事实捋清,再说影响和老达的看法。
一、事实梳理:三原则、一串内部数字、一个交易所
组织进化三原则:打破岗位边界(岗位是工业时代的单元,任务是智能时代的单元,未来岗位收敛为 Builder 和 Seller 两类——创造的人与连接的人);沉淀隐性知识(员工经验显性化、沉淀到平台,才叫组织智能,「这种组织能力别人抄不走、挖不动、买不来」);设计流程闭环(公式:可衡量 + Looping = 持续进化)。
支撑这三点的是百度自己的内部数字:日活智能体数(DAA)从日均 0.5 万涨到 3.7 万,涨了六倍多;智能体完成的有效任务从每周 8.4 万个涨到每周超过 100 万个;已建 4300 个 Workspace,沉淀组织 Skill 超过 2 万个。
词元所是这次最实的产品。李彦宏的解释很朴素:今年前 9 个月几乎每天都有新模型发布,但词元中转站不对模型效果和服务稳定性负责,「同一款模型,有的贵有的便宜,来源五花八门,质量参差不齐,选来选去就是不放心、不敢用」。词元所主打两个能力:验真(模型指纹比对、能力测试、性能与可用性测试)与征信(定期抽检拨测、全链路实时监测调用,给模型提供商建信用评级)。官方口径:上线一个月,入驻供应资源超 100 个,日均调用突破 5000 万次,日均调用 Token 超 7000 亿。
模型与智能体侧:文心 5.5 Flash Preview 发布,总参 2800 亿、每 Token 激活 140 亿、支持 100 万 Token 上下文;文心闪电深度思考、文心一镜微表情两款应用模型上线千帆。四大智能体全线升级——百度搭子变成连接全系专业智能体的统一入口,并开放 Harness 引擎与 Agent API,团队半年迭代 160 多次、90% 的代码和 50% 的对外物料由搭子生成;一镜加了短漫剧 Studio,视频生成成本压到每秒 0.2 元;库库与海外版 KOOKO 依托 18 亿专业内容与 7.5 亿中英文文献;伐谋 3.0 面向生产运营与产业研发,客户覆盖 41 个工业大类中的 25 个。底座侧天池 1024 卡超节点发布,昆仑芯 M100 已上市、M300 明年推出。
二、影响一:Token 的计价口径,走到了第五代
把这一年各家公布的计价方式排一排,会发现一条很清楚的路线:
第一代按席位(坐席数 × 月费),第二代按 Token 包(预充值、按量扣),第三代按任务(一个任务一个价,看着像打包,其实把不确定的长尾成本转给了卖方),第四代按运行时长——Kimi Hosted Agents 是沙箱小时 0.072 元 + 模型推理 + 插件调用次数,常驻型产品则是按时间烧额度。现在词元所是第五代:把 Token 当成可交易的标准品,价格由平台撮合、质量由平台抽检。
这个变化对采购的影响比看上去大。前四代的采购动作是「谈折扣、锁年度框架、算够不够用」;交易所化之后,采购动作变成「看信用评级、看拨测记录、比同一模型在不同供应商处的价差」。也就是说,供应商从「模型厂商」变成了「Token 经销商」,多了一层可替换性。这件事在云服务器、CDN 上已经发生过一遍,现在轮到模型调用了。
对企业最直接的一条:如果你的 Agent 只依赖某一家模型的官方 API,议价空间是零;如果它跑在标准接口上(OpenAI 兼容、或者 MCP 这类协议层),你就可以在交易所里挑便宜的。这就是为什么这一年各家都在推「开放 Harness 引擎与 API」——腾讯 Buddy One 讲共享底座,Agent 运行底座被两朵云同时产品化,逻辑是同一个:谁掌握运行层,谁就不怕模型层打价格战。
三、影响二:交易所解决的是信任成本,不是适配性
词元所的两个能力,说白了是替采购方回答两个问题:「这是不是真模型」和「这家供应商稳不稳」。这两个问题以前没人管,确实是空档。
但它回答不了第三个问题,也是最贵的那个:这个模型适不适合我的任务。模型指纹能证明「确实是文心 5.5 Flash」,不能证明「我的合同审查任务它能跑到 92%」。能力测试是平台出的题,不是你的题。这一点和评测榜单的困境一模一样——榜单比的是「模型 + harness 组合」,同一模型换个 harness 分数能差一倍,你的 harness 跟平台测试用的那个不是一回事。
所以正确的用法是把它当「准入清单」而不是「选型结论」:先用交易所筛掉假货和不稳定的供应商,剩下的两三家,拿自己的评测集跑一遍。谁家的题都不如自己的题准。
四、影响三:三原则里最实的是第二条,最虚的是第一条
第二条(沉淀隐性知识)是真东西。4300 个 Workspace、2 万个组织 Skill,这两个数字比 DAA 有意义得多——它意味着「一个人的做法变成了全公司可调用的能力」。这件事的工程含义是:Skill 要当资产管,要有版本、有责任人、有验收标准、有淘汰机制。我们之前聊过让 Skill 进 Git 走评审,逻辑没变,只是现在被摆到大会主舞台上了。
第一条(岗位收敛为 Builder 和 Seller)目前是话术。两类岗位的划分在咨询 PPT 上很好看,落到编制表上是另一回事:财务、法务、质量、安全这些岗位,既不是纯创造也不是纯连接,它们的存在理由是「责任要有人签」。只要签字责任还在人身上,岗位就不会收敛成两类。真正在收敛的是执行类岗位的编制数,不是岗位种类。
第三条(可衡量 + Looping)缺一环。公式没错,但「可衡量」的前提是有人定义什么算「有效」。前面那个「每周 100 万个有效任务」——有效是谁判的?如果判据是「Agent 自己说完成了」,这个数就只能当趋势看,不能当业绩看。
五、老达点评
一、DAA 从 0.5 万到 3.7 万,是增长速度,不是普及程度。这是百度内部口径,且分母是「百度自己的员工 + 搭子用户」,横向比不了任何友商。真正值得看的是「人均日活智能体数」和「任务完成率」,可惜这两个数没给。
二、每周 100 万个任务,说明任务被切小了。从 8.4 万到 100 万,涨了十一倍,同期 DAA 只涨了六倍多。人均智能体涨得比人多,任务涨得比智能体多——最可能的解释是「原来一个大任务被拆成十几个小任务派给不同 Agent」,这是架构进步,但不等于创造的价值涨了十一倍。这个区别在做预算的时候很要命:任务数涨十倍,Token 成本也涨十倍,利润没动。
三、词元所最关键的问题是:征信谁出。如果信用评级由平台自己算、自己发布,中立性天然要打折——这跟厂商自己跑分一个道理。「模型指纹比对 + 定期拨测」这套方法本身是好的,我建议每个有模型采购量的企业照抄一份,做成自己的准入清单:固定 20 道题、每月拨测一次、记录延迟与失败率。这套东西花不了几天,但比任何榜单都贴合自己的业务。
四、对中小团队最有用的一条,不是交易所,是「把 Skill 当资产」。2 万个 Skill 听着吓人,但拆开看就是「把老师傅的做法写下来」。你们公司可能只有 30 个流程值得沉淀,把它们写成 Skill,配版本号和责任人,半年后新人上手时间能砍一半。这件事今天就能做,不用等任何平台。
五、「AI 没产生预期经济效益」这个判断,我同意一半。同意的是:只买模型不改流程,确实不涨利润,本站写过太多「上了 Agent 但没人看报表」的例子。不同意的是把原因全归到「组织」——很多企业的问题更靠前:数据不通、系统没接口、责任边界没定。组织变革解决不了接口缺失。上一轮百度讲「搭子进车间」时就承认「存量系统没有 API」,这个问题今天还在。
六、五个未解
一是评级方法会不会公开。不公开方法,评级就只是一个分数,采购没法复核。二是跨平台的 Token 能不能互认。词元所里的 Token 出了这个平台还能不能用,决定了它是「交易所」还是「自家商城」。三是抽检发现问题后的责任划分。抽检发现某供应商的 Token 质量不达标,已经调用过的客户损失谁承担。四是词元所和千帆的关系。一个是交易、一个是开发平台,两边如果各有一套模型目录,企业会更晕。五是组织指标怎么审计。DAA、有效任务数这类指标,将来会不会进财报口径,如果会,判据就必须写清楚。
七、总结
这次大会讲了两个层面的东西。产品层面,词元所是个真需求——模型多到没人能选,确实需要一层「验真 + 征信」的中间商;搭子开放 Harness 与 Agent API 也是实在的开放动作。叙事层面,「智能组织」「岗位收敛为两类」是给决策层听的,判断标准很简单:一年后看它自己的编制表变了多少。
对做技术的人来说,值得拿走的是三样:Token 采购要留出可替换性(别把 Agent 焊死在一家 API 上);自己的评测集比任何榜单都重要(Super-agent 那类架构再好,也得在你的任务上跑过才算);Skill 要按资产管理(版本、责任人、验收、淘汰,四样缺一不可)。这三样不需要等平台,今天就能动手。