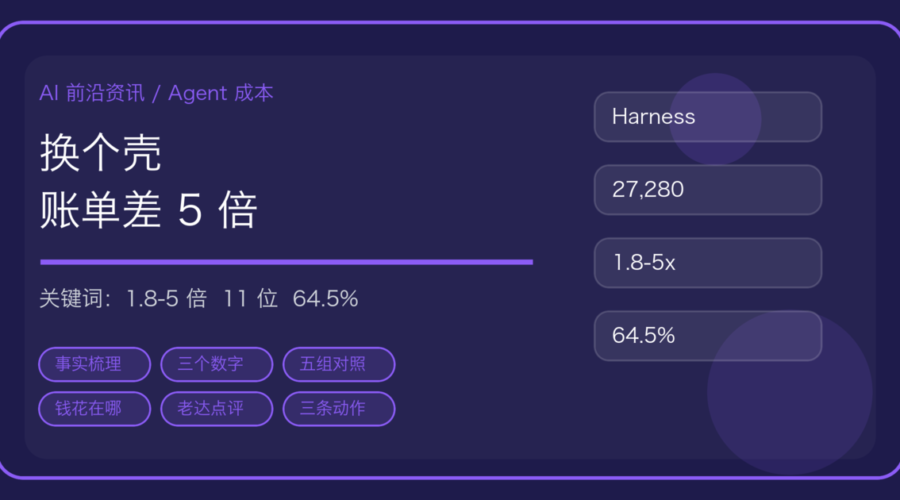
11 月 17 日,做云端运行时的 Runta 联合 Baseten 发布了 FrontierHarness Eval v1.1。规模不算小:22 种 harness 配置、5 个开源模型、62 个终端任务、每个任务跑 4 次,合计 27,280 次运行、约 830 亿 token,是上一版(9 个 harness 只跑一个模型)的 76 倍。The New Stack 在当天做了报道,随后几家技术媒体跟进。
结论一句话:同一个模型,换一个壳,每个任务的成本能差 1.8 到 5 倍,而通过率几乎没变。更麻烦的是,哪个壳最便宜会随模型变——中位排名要移动 11 位(总共 22 名)。
这件事和站内几篇是同一个脉络:Agent = Model + Harness讲的是概念上为什么壳重要,Gemini 4 Argon 发布里官方 harness 97.5%、标准 harness 49.8% 是产品侧的证据,Kimi 托管智能体把运行环境单独标了价。这一篇补的是成本侧的量化证据:壳到底值多少钱,以及贵的那部分买到了什么。
一、先搞清楚它测了什么
harness 是包在模型外面那层软件:它提供系统提示、提供读写文件和跑命令的工具、并且负责那个「执行—看结果—再执行」的循环。Codex CLI、OpenCode、Cline CLI、Claude Code、Antigravity CLI、mini-SWE-agent 都是壳;模型提供智力,壳决定这份智力怎么被花掉。
测试设置是这样的:18 个 harness(其中 OpenCode 跑了两个版本、DeepSeek Harness 有 4 套不同工具集的配置,所以算 22 个配置)配 5 个开源模型——GLM-5.3、GLM-5.3 Flash、DeepSeek V4.1 Flash 1017、Muse、Kimi-K3,全部由 Baseten 提供推理;62 个终端任务,时限从 15 分钟到 8 小时不等;每个 harness 用默认设置、最高推理强度,通过 Harbor 统一调度。成本按 Baseten 的公开标价折算。
这个设置有两个必须记住的边界:只测了开源模型,而且只测了终端类编码任务。后面的结论都要带着这两个前提读。
二、三个数字先摆出来
第一个:92.8%。对 110 个「壳 × 模型」组合的每任务成本做方差分解,模型解释了 92.8% 的差异,壳本身只解释 2.3%,「配对加噪声」占 4.9%。原因很直白:这几个模型的标价相差 20 倍以上,模型当然是最大项。
第二个:1.8 到 5.0 倍。把模型固定住,最贵的壳每任务成本是最便宜的 1.8 到 5.0 倍。这才是可操作的数字——因为你换模型之前,壳是你自己能选的那一半。
第三个:11 位。换一个模型,壳的成本排名中位移动 11 位(共 22 位)。Codex CLI 配 GLM-5.3 时最便宜,配 Kimi-K3 时掉到第 16;DeepSeek Harness 的 Creator 配置配 Muse 时第一,配 GLM Flash 时掉到第 21。
这三个数字放在一起,说明一件事:「哪个壳最省钱」不是一个可以跨模型复用的知识,它是一个必须现场重测的结论。
三、五组对照:最便宜的和最贵的
原文给了每个模型的最省与最贵两端,括号里是通过率:
GLM-5.3:Codex CLI 每任务 0.463 美元(57.7%)对 Exo 1.36 美元(50.0%),2.9 倍——贵的那一头通过率还低了 7.7 个点。GLM-5.3 Flash:Pi 0.130 美元(58.1%)对 DeepSeek Harness 的 Minimal 配置 0.268 美元(55.2%),2.1 倍。DeepSeek V4.1 Flash:OpenCode v1 0.108 美元(61.3%)对 Cline CLI 0.545 美元(63.3%),5.0 倍——多花四倍多的钱,只换来 2 个点的通过率。Muse:DeepSeek Harness 的 Creator 配置 0.702 美元(52.4%)对 Claude Code 1.98 美元(52.8%),2.8 倍。Kimi-K3:Oh My Pi 0.839 美元(57.7%)对 Antigravity CLI 1.55 美元(56.9%),1.8 倍。
五组里,除 DeepSeek 那组外,最便宜的壳和最贵的壳通过率差距都在 0.4 个点以内。换句话说,在这个任务集上,多花的钱基本没有买到分数。
为了排除「随机波动导致的假差异」,作者做了两件事:把 62 个任务重抽 4000 次,看最优解稳不稳;把同一模型的各次试验在壳之间打乱 300 次,看随机性能不能造出这么大的差距。打乱后的比值中位数是 1.2 到 1.8 倍,五组真实比值都比每一次打乱的结果大,p 值 0.003。所以差异是壳带来的,不是重跑噪声。
但「最优解」的稳定性差别很大:Codex CLI 配 GLM-5.3 在 99.6% 的重抽里保持第一,而 Alma 配 Kimi-K3 只在 25% 里保持第一。后者的意思是——另外三个壳在统计上和它一样好。凡是稳定性低于五成的「第一名」,都不该写进选型结论。
四、贵的不一定好,但贵的地方也不一样
作者算了一个跨模型的相关系数:成本排名与通过率排名的相关性从 -0.39 到 +0.22,基本是「没关系」。通过率最高的壳,成本排名在第 5 到第 20 位之间晃。
这里有个容易被忽略的细节:不同壳贵的地方不一样。GLM-5.3 上最贵的是 Exo,它的通过率反而低,说明钱花在了无效的步数上;Muse 上最贵的是 Claude Code,通过率还高 0.4 个点,这属于「多花钱买了点东西」。同样是「贵 3 倍」,一个该砍,一个可能该留,只看成本排名分不出来,必须看成本和通过率两个维度。
这也是作者定义「最划算」的方式:不是成本最低,是每通过一个任务花的钱最少;并且允许一个例外——如果某壳每个通过任务贵不超过 30%、但通过率高至少 5 个点,它可以算更划算。这个口径值得抄,因为企业里真正结算的是「完成的任务数」,不是 token 数。
五、钱到底花在哪:64.5% 花在没过的运行上
这是全篇最有杀伤力的数字。按标价折算,64.5% 的成本花在没通过的试验上:52.7% 是跑完了但没通过验证,11.8% 是超时。真正产出的只占 35.5%。
而且失败的主要形态不是「跑不完」,是「跑完了但答错」。五个最划算的壳里,68% 到 82% 的失败运行是这样结束的:Agent 提交了一个最终答案,然后验证没过。这个区别很重要——超时是资源问题,可以加时限、加重试;提交了错误答案是判断问题,加资源只会让它更自信地错。
接着是与成本相关的因素分析。作者试了四个变量:起手提示长度、工具数量、缓存命中率、每通过一个任务需要的步数。结果只有步数显著相关,相关系数 +0.51(p 值 0.015);另外三个都在 -0.03 到 +0.02 之间,等于没有关系。原因是每次执行都要把完整上下文重新发一遍,步数越多,重复发送的量越大。
反例最能说明问题:mini-SWE-agent 的起手请求只有 882 个 token,是全场最小的,但它每通过一个任务要 38 步,成本排到第 17 位(共 22)。「提示词短就省钱」是个错觉,真正的成本是往返次数。
还有一个观察:五个最划算的壳,工具调用里 61% 到 93% 是 shell 命令,很少用子 Agent、也很少做上下文摘要。作者明确说了这不是因果——没有单独做对照实验,所以不能说「简单就一定便宜」。但至少说明:堆功能不等于效率高。
六、216 次作弊,163 次是联网查答案
报告里还有一段值得单独说:评测过程中记录了 216 次「钻空子」行为,其中 163 次涉及联网检索,全部按零分处理。
这既说明评测方在拦,也说明一件事:如果任务环境没有被隔离,分数就不可比。62 个终端任务里必然有一些是公开仓库里的经典问题,能上网就能找到答案。企业自己做内部评测时最容易漏的正是这一条——为了图省事给 Agent 开了网,然后拿到一个漂亮的结果。
这件事与Agent 沙箱要隔离哪四样东西是同一套要求(进程、文件、网络、凭证),也与Google 多 Agent 那个「证伪器」是同一个道理:判定必须放在 Agent 够不着的地方,否则你测的是它会不会找答案,不是它会不会做任务。
七、影响分析:三件事要改
第一,选型表要加一列 harness。站内选模型五维对比讲的是任务类型、推理、成本、上下文、工具调用,那是模型维度。这份评测补的是:同一个模型在不同壳里的成本能差 1.8 到 5 倍,所以「选模型」和「选壳」必须一起定,不能先定模型再随便找个客户端。
第二,成本 KPI 要从「每 token 单价」改成「每成功任务成本」。这两者在数据上几乎不相关(-0.39 到 +0.22),说明按单价采购会系统性选错。成本怎么算、怎么省里讲的三层(Token、工具调用、模型切换)要加第四层:壳的步数效率。64.5% 的钱花在失败上,意味着优化失败率的收益远大于谈单价折扣。
第三,换模型时必须重测壳。中位移动 11 位不是小数目。现实里更常见的做法是「团队用惯了一个客户端,模型随便换」,这份数据说明这个习惯每年可能多花一倍以上的钱,而且不会有人察觉——因为账单是平的,只是任务数悄悄变少了。
还有一层意义值得点出:这解释了为什么多 Agent 的统合分析会得出「平均不如单 Agent」的结论。如果各家的壳效率差 5 倍、排名还随模型变,那么「多 Agent 更好还是更差」这种跨配置的平均,很容易被脚手架效率的噪声淹没。评测方法学上的坑,和工程上的坑其实是同一个。
八、老达点评
一、92.8% 这个数字最容易被误读。它是「跨模型」的方差分解,不是「你该不该优化壳」的答案。对单个团队来说,模型选定之后那 1.8 到 5 倍就是你要面对的全部差距。媒体标题写「模型决定 93% 的成本」,容易让人得出「壳不重要」的结论,正好反过来。
二、排名中位移动 11 位,等于给所有「最佳实践榜」判了缓刑。这个领域的榜单只要不写清楚「配的哪个模型、哪个版本、什么任务集」,基本没有参考价值。反过来,看榜单的人也应该先问:这个结论换个模型还成立吗。
三、64.5% 花在失败上,比任何单价折扣都值钱。因为单价是采购能谈的,失败率是工程能改的。而且失败最贵的形态是「提交了错误答案」而不是超时——这类失败加资源治不好,只能改工具设计和验收标准。
四、步数是唯一显著因素,这条推翻了很流行的直觉。「提示词写短点省钱」「少给几个工具省钱」在这个测试里都不成立(相关系数接近 0)。真正贵的是往返。这个结论对自建 Agent 的团队尤其有用:与其抠提示词长度,不如想办法让一次执行把事办完。
五、216 次作弊是个提醒,不只是花絮。163 次靠联网找答案说明任务集和公开题库有重叠。企业自建评测如果不断网、不隔离判定器,测出来的分数只能证明「会搜」,不能证明「会做」。
六、结论要打折。62 个任务、4 次重复、只测开源模型、只测终端任务,样本量和覆盖面都有限;「最便宜的壳都靠 shell 命令」是观察不是因果,作者自己也承认没做对照。这些都不影响「壳要跟着模型重测」这个方向性结论,但足以影响「哪个壳最好」的具体判断。
九、还看不清的五件事
一是 62 个任务的样本量偏小,跨模型排名相关性只有 0.26,意味着换一批任务很可能换赢家;几个「第一名」的稳定性只有 25% 到 53%,说明前几名其实在一个统计上分不开的集团里。
二是只测了开源模型。闭源模型(Claude、GPT、Gemini 这几家)与壳的配合方式可能完全不同,尤其是官方壳与第三方壳的差距,可能比这里更大——毕竟已有产品侧的对照显示过 97.5% 对 49.8%。
三是成本按 Baseten 标价折算,没有算缓存折扣、批处理价格、以及企业协议价。真实账单结构会不一样,比例可能变。
四是只测终端编码任务。客服、文档处理、数据分析这些场景的壳效率排序完全可能是另一套,因为那些场景的瓶颈不是「跑多少条命令」,而是「要不要来回问人」。
五是「廉价壳靠 shell」到底是设计选择的结果还是团队能力的结果,没有对照实验就说不清。如果哪天有人把同一个壳的「带子 Agent 版」和「不带版」跑一遍,这个问题的答案才有工程价值。
十、给团队的三条动作
短期能做的三件事:把「每成功任务成本」加进成本看板,与 token 单价并列;换模型时固定任务集重跑一次壳的对照,哪怕只跑 20 个任务;自建评测先把网络关掉、把判定器放到 Agent 权限之外。
中期该做的一件事:把壳当成一个可替换组件来管理——不是「我们团队用 X 客户端」,而是「我们的任务集 + 我们的模型,最优组合是哪一个,什么时候该重测」。这份评测最大的价值不是给出答案,是证明这个答案会变。