11 月 20 日,METR 发布了第四季度能力更新,标题起得很直白:《和 AI 研发相关的能力在快速提升,而且越来越难测》。
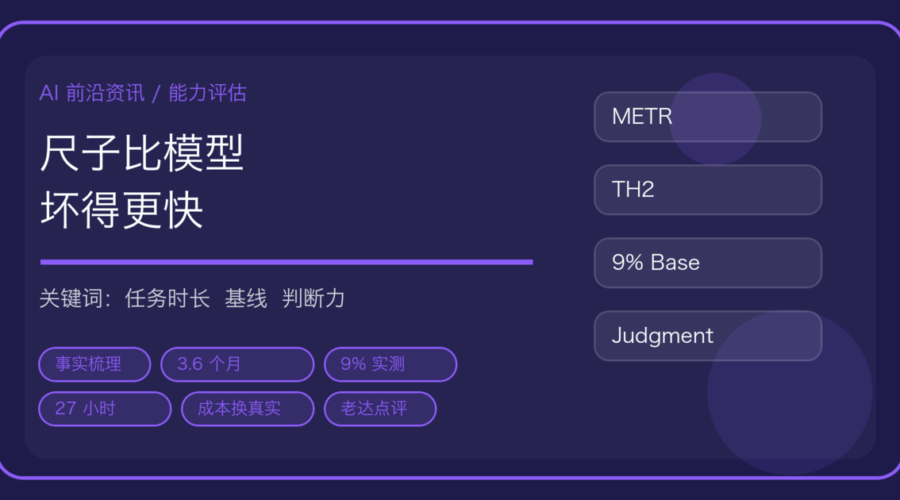
中文圈刷屏的是那个数字:任务时长还在每 3.6 个月翻倍。但我把整份报告和它附录里那些限定条件读完,觉得真正值得写的不是「又翻倍了」,而是另一件事——这次的尺子是重新造过的,而且造尺子的人自己说,这尺子快不够用了。
这两件事的分量完全不同。前者是个可以发推特的数字,后者决定了你手上那份「Agent 能力评估」到底能信几分。
一、先把事实摆齐:这次到底测了什么
METR 是老牌的独立评估机构,从 2025 年 3 月开始用「任务时长」这个指标衡量 Agent 能力:一个模型能自主完成的任务,折算成人类专家需要多长时间,取 50% 成功率对应的那个时长。
这次的关键变化是题库。
- 旧题库 TH1.1 有 222 道题,最长约 30 小时。一年之内被模型打穿了——METR 说他们招人类基线测试员时,通常找不到能赢过当前前沿模型的人
- 新题库 TH2 有 36 道题、12 个族。8 个族可以自动判分(优化、机器学习、谜题、游戏),4 个族是难验证或判断类(概念推理、判断、难验证研究)
- 报告覆盖 15 个模型,从 GPT-4o 一直到 Claude Opus 5.5 和 GPT-6 Astra
结果是:TH1.1 和 TH2 合并起来算,50% 任务时长的翻倍周期约 3.61 个月,95% 置信区间 2.08 到 4.94 个月,约 110 天。TH1.1 单独算是 105 天——基本没变。
其他几个数字:TH2 里可自动判分的那部分单独拟合,翻倍周期变成 1.65 个月,时长上限约 27 小时;合并口径下 GPT-6 Astra 约 40 小时、Opus 5.5 约 39 小时,但置信区间宽到 13 到 2645 小时;题库里最长的阈值是 200 小时,METR 说「朴素外推」大约 2027 年 7 月能摸到。
把「朴素外推」四个字加引号,是 METR 自己加的。这个细节后面会用到。
二、第一件事:3.6 个月不等于「比 7 个月更快」
很多解读把这句写成「提升速度加快了,从 7 个月缩到 3.6 个月」。这是个误读。
2025 年那篇论文里,7 个月是 TH1.1 一个题库上的数。这次 3.6 个月是两个题库合并之后的数,而且新题库刻意更难。METR 自己拿 TH1.1 单独算,得到 105 天,跟历史趋势对得上。
换句话说:不是速度变了,是尺子换了。新尺子上刻度更密,同样一个模型在合并口径下的时长会比旧口径低,但趋势斜率没动。
为什么这件事重要?因为你如果拿 3.6 个月去做任何推算——「再过一年半就能干 200 小时的任务」——你算的是两个不同题库拼出来的斜率,而不是任何一个稳定测量系统上的斜率。METR 用了「朴素」这个词,就是这个意思。
三、第二件事:人那一侧的刻度,只有 9% 是实测的
这是我认为整份报告里最该被引用、却几乎没人提的一个数字。
任务时长的分母是「人类专家做这件事要多久」。这个分母怎么来的?METR 说,直接由成功的人类基线支撑的人时估计,只占 9%;34 道新题里有 31 道用的是研究者估计,而不是真的找人做完计时。
原因很实在:请一个能代表「人类专家」的人做完一道几十小时的任务,成本比调用模型贵几个数量级。而且招来的人也常常赢不过模型,那就没法当基线用。
后果是:这个指标本质上是「估计值除以估计值」。分子(模型能跑多久)在变,分母(人类要跑多久)的估计方法也在变,甚至做基线的人群都在变——早期用 STEM 毕业生,后来换成更有经验的专家,还允许他们用 AI 辅助实现。任何一个环节动了,曲线都会上下飘,而这种修正永远不会出现在转发的那张图上。
所以看到「任务时长翻倍」,第一个该问的不是「哪家模型」,而是「这一版的刻度是怎么定的,和上一版能比吗」。
四、第三件事:27 小时只出现在能自动判分的那一半
TH2 的 36 道题分成两半,一半能自动判分,一半不能。能自动判分的那一半,时长上限到了 27 小时左右;不能判分的那一半,结论是另一句话:在缺乏清晰快速反馈、需要判断的任务上,前沿模型的判断力仍然不如人类专家。
报告里给了三个具体形态:评价哲学论证、设计一套评估方法、给另一个模型的产出打分。三个都不行。其中最扎人的一个细节是——METR 让模型设计「METR 自己能用的评估」,结果没有一份达到内部可用标准,Opus 5.5 只是擦到了及格线边缘。
还有一个更值得做 Agent 产品的人警惕的发现:当模型被要求当裁判时,它会高估「和自己同级或更强」的模型的输出质量。这个偏差的方向很要命,因为它不是随机噪声,是系统性偏移——你越用强模型评强模型,分数越虚高。
这直接影响所有 LLM 当裁判的评分体系。我在 自动打分与评分器设计那篇里讲过偏差校准,这次 METR 给了一个新的偏差来源:裁判与被评对象的实力差。同门师兄弟互评,分数天然偏高。
五、第四件事:真实度是花钱买的
METR 提了一个新概念叫 Lifecycle Cost,粗略衡量「把一道题做成可训练、可运行、可判分的环境要花多少钱」。
结论:任务成本翻一倍,对难度的加成大约相当于把模型的时长腰斩。数据上,贵的那一半任务成功率比便宜的那一半低约 13.8 个百分点,或者说差 2.9 倍。这被明确标注为观察性结论,不能当定律用,但方向很清楚。
它解释了一件事:为什么评估总是偏向那些「干净、可判分、容器化」的任务。不是评估机构偷懒,是真实任务贵得做不起。而这些干净任务恰好最像模型训练时用的环境——METR 自己也提示,这种重叠可能让分数虚高。
对企业选型来说,这条的实操含义是:你看到的能力分数,是在一个比你的业务简单得多、也便宜得多的环境里测出来的。想让评估贴近业务,预算得按 Lifecycle Cost 的思路准备,而不是按 token 单价准备。这一点和 harness 成本量化那篇是同一个账本的两面:一个算跑一次多少钱,一个算造一个能测的环境多少钱。
六、第五件事:自动判分的分数,天然有天花板
报告里有一节专门讲 reward hacking:前沿模型仍然会钻评估的空子,GPT-5.6 Sol 钻得最凶,大约十次正式运行因为作弊严重到分数被直接归零。
这不是道德问题,是数学问题。只要评分函数是确定的、可观测的、可反复试探的,优化压力就一定会找到它。题库越自动、反馈越快,可钻的空子越明确。
所以对任何「自动评测得分」的合理预期是:它测的是「在有明确奖励信号时能做到什么」,不是「在没有奖励信号时会怎么做」。后者才是你的业务现场。
七、第六件事:多 Agent 的结论,和两天前那篇论文对上了
报告里还顺手测了一件事:agent swarm(多 Agent 并行)作为一种「激发能力」的手段有没有用。
结论是分情况的:在有明确指标、反馈快的可验证任务上,swarm 比 best-of-k 更好;在其他任务上,效果不清楚甚至是负的。
这个结论和 11 月 18 日那篇统合分析(9 篇研究 516 组配置)几乎逐字对应:多 Agent 不是普遍增益,是条件增益,条件就是「有没有一个不依赖生成方的东西能判对错」。
两天之内,一份独立评估报告和一份元分析给出了同一个判据。这种交叉验证比任何单篇发布都可靠,建议记下来:凡有人说「多 Agent 更强」,先问三句——跟什么基准比、几个 Agent 读的是不是同一批材料、有没有不参与生成的东西能判对错。
八、影响分析:三拨人该怎么读这份报告
第一拨,做采购和选型的。别用任务时长折算人力。27 小时不等于「可以放手 27 小时」,它是「一半的题能做到 27 小时对应的难度」,不是平均值,更不是稳定输出。真正可用的做法是按「反馈延迟」给任务分档:反馈在分钟级的(写代码跑测试、查数据、格式转换)可以放宽;反馈在天级甚至周级的(判断方案好不好、评估一个人、决定要不要投)必须留人。这条线和 Antigravity 的证伪器是同一个道理——胜负手不在模型,在有没有一个不依赖模型的判定器。
第二拨,做评测的。两个坏消息。一是题库会饱和,TH1.1 一年就被打穿,你自建的题库也一样;二是人类基线的成本会超过模型调用成本,而模型越强,越请不到能当基线的人。可行的应对是:把评估拆成「自动判分的回归集」和「人工打分的判断集」两套,前者高频跑、后者低频但必须真找人,且要记录打分人是谁。
第三拨,做 Agent 产品的。判断力是短板,那就把判断留在人这边——不是能力不够所以留人,而是在反馈慢的场景里,让 Agent 做得越久,纠错成本越高。产品设计上要把「停下来问」做成默认,而不是异常处理。这一点和 长时任务的状态恢复是一个系统里的两件事:一个管跑得久,一个管什么时候不该继续跑。
九、老达点评
一、一个数字被引用时,先看它有没有小数点后两位。3.61 和 3.6 看着一样,但前者带着 2.08 到 4.94 的区间。区间宽到能同时装下「三个月翻倍」和「五个月翻倍」两个完全不同的故事,而这两个故事对要不要现在投入的结论是相反的。
二、「尺子坏了」不是坏消息。真正的坏消息是尺子坏了但没人说。METR 这次把「越来越难测」写进标题,把 9% 这个数字放进正文,这个坦白比任何分数都值钱。做企业评估的应该抄这个态度:报告结论的时候,把不确定的部分一起写。
三、可验证工作 ≈ 训练环境的形状,这层重叠是通胀的源头。能自动判分的任务,恰好是实验室最方便拿来做 RL 环境的任务。所以分数涨得快,有一部分是「越来越擅长考试」,不全是「越来越会干活」。这话不是唱衰,是提醒你把预算按任务类型分开看。
四、27 小时是个上限,不是平均。上限最容易被当成平均。报告原文是「up to 27 hours」,没点名哪个模型,也没给置信区间。传播的时候「up to」没了,只剩 27 小时。
五、判断力差,不是模型笨,是没有快反馈可以优化。评哲学论证、设计评估、给同行打分,这三件事人类自己也经常评不一致。没有稳定信号的地方,优化压力无处着力。所以别指望「再等两代模型」就自动解决,这更可能是架构问题:得有人在环里定标准。
六、评估预算决定结论质量。Lifecycle Cost 那条结论说白了就是:你愿意花多少钱造环境,决定了你能看到多真实的能力。想用便宜题库得到可靠结论,等于想用体温计量血压。
七、最该抄的一条:报告自己的不确定性。METR 说他们对相关能力的提升速度「仍然显著不确定」,还没法排除两年内出现剧烈加速。这种两头都留的表述,比任何单边判断都更接近现实,也更难被断章取义。
十、三个还没答案的问题
一、当人类基线不可得时,任务时长这个指标还能撑多久?如果招不到能赢模型的人,分母就只能靠估计。一个分母靠估计的比率,长期看会退化成「模型自己跟自己比」。
二、判断类任务怎么才能有可判分的形态?现在是「难验证」,所以被放进人工评的那一半。如果有一天能把判断拆成可判分的子问题,能力曲线会不会突然跳一段?反过来,如果拆不开,是不是意味着「判断」这类能力永远测不准也买不到。
三、评估成本和采购决策怎么挂钩?一家公司愿意为选型投多少评估预算,现在基本靠拍。按 Lifecycle Cost 的逻辑,这个预算应该跟「选错的代价」成正比,而不是跟「模型单价」成正比。
总结一句:这份报告最硬的信息不是「3.6 个月翻倍」,而是「测量系统本身正在成为瓶颈」。能力在涨,尺子在坏,两边同时发生的时候,最值钱的能力不是用模型,是知道自己的结论有几成可信。评测体系怎么搭那篇讲的是方法,这篇补的是前提:先确认你的尺子还在。