11 月 4 日,腾讯混元发布 Hy4 正式版。距离 10 月 29 日生态大会上那句「Hy4 即将发布」,只隔了六天。
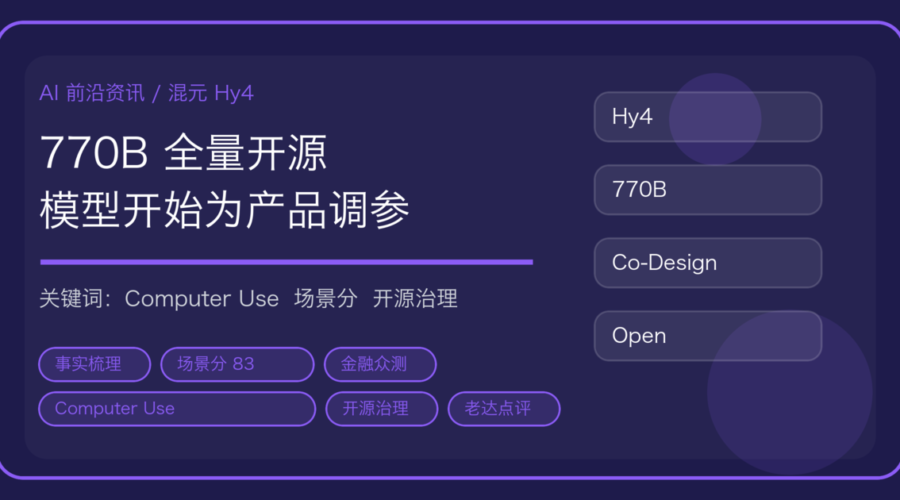
先把事实摆清楚,再说这篇真正想讲的东西:这次发布最值得看的不是 770B,而是「模型开始为一个具体产品调参」这件事被摆到了台面上。
一、事实:770B、三个「首次」、定价没动
Hy4 系列总参数 770B,采用 MoE 架构,激活参数 49B,上下文 1M。这个规格并不新鲜——8 月 28 日开源的 Hy4 preview 就是 770B / 49B / 1M,Apache 2.0。真正变的是能力项:
首次引入视觉理解。结合视觉、推理和工具调用,做细粒度图像处理、复杂图表分析、数学视觉推理这类任务。
首次支持电脑操作(Computer Use)。能结合命令行和图形界面执行任务,而不是只在对话框里输出文本。
首次针对专业软件做专项训练。点名的是 Blender、CAD,以及跨应用的长程任务。这一条容易被忽略,但它信息量最大,后面单独说。
除此之外,指令遵循、长文本理解、长程 Agent 能力都有提升。官方给的对比基准里,ProgramBench、FrontierCode 2.0、Agents’ Last Exam v1.1、Terminal Bench 4.0、OSWorld 2.1 这几项,Hy4 超过 DeepSeek-V4.1-Flash-1017,部分接近 Kimi K3.1 Pro,个别项目超过 GPT-6.1 Sol;但多数基准仍低于 GPT-6.1 Sol 和 Claude Opus 5.5。
这一点混元自己说得很直白:「尽管 Hy4 已经是目前最强的开源模型之一,但与顶尖闭源模型仍然存在较大差距。」这句话放在发布稿里,比任何跑分都可信。
上线节奏也很快。腾讯云 TokenHub、WorkBuddy/CodeBuddy、元宝、企业微信智能助理大圆、ima 都已经上了;API 同步接入 OpenRouter、Hermes、OpenCode;QQ、王者荣耀、和平精英、微信读书、腾讯新闻在陆续接入。
定价延续 preview:输入 6 元/百万 token,输出 18 元,缓存命中 0.3 元。能力涨了,价格没动。Hy4 Flash 近期推出,定位极致性价比。另外两个时间窗对读者有用:11 月 4 日到 11 月 15 日,WorkBuddy 和 CodeBuddy 给一定额度的免费使用;即日起到 12 月 31 日,TokenHub 按刊例价五折计费。
二、「83.18 分」是什么分:它考的不是模型,是模型加产品
发布稿里最抢眼的一组数字不是跑分,是这个:WorkBuddy 评测平均效果得分 83.18 分,任务通过率 96.15%,12 个测试场景中有 9 个排名国内第一。
这组数字要拆开看。
它不是通用能力评测。它考的是「在 WorkBuddy 这个产品的工作流里,模型能不能把活干完」——文档写得好不好看、人机双写稳不稳、多轮修改会不会崩。官方明确说,针对 WorkBuddy 的人机双写功能,Hy4 在文档美观度、稳定性和可用性上都有明显提升。
这就是所谓的 Co-Design:模型和产品一起调。模型团队知道产品里有哪些具体动作、哪些地方容易翻车,就在训练和后训练里针对性地喂。
这种做法的好处很实在。通用榜单考的是「会不会做题」,产品场景考的是「交付物能不能用」。用户在 WorkBuddy 里不满意的地方,八成不是模型不会推理,是排版崩了、格式丢了、改到第三轮开始胡说。这些在通用榜单上一分都体现不出来。
但代价也要说清楚:96.15% 是自家产品、自家题、自家判分。它证明的是「这个模型在这个产品里表现好」,不能直接推出「这个模型在你的场景里也好」。同一套模型换一个 harness,分数能差一倍——Gemini 4 Argon 那次已经演示过一遍,官方 harness 97.5%、标准 harness 49.8%。
所以看这类场景分,正确姿势是看趋势不看绝对值:preview 到正式版提升了多少、哪个场景提升最多、哪个场景还是短板。绝对值留给厂商去宣传。
三、金融众测:213 位外部专家、579 个真实任务
比场景分更值得看的是金融那一段。
混元联合腾讯金融科技 FiT 做了盲测:213 位专家参与,其中 153 位来自外部头部金融机构,七成有五年以上工作经验;题库是 579 个真实金融任务。结果 Hy4 综合 3.04,DeepSeek-V4.1-Flash-1017 是 2.97,Kimi K3.1 Pro 和 GLM-5.3 都是 2.68。另外在金融智能体公司讯兔科技的内部评测 IRAB 里,Hy4 比 preview 提升 12.03 个百分点。
这套设计比刷榜贵得多:找两百多个真专家、出五百多道真实任务、做盲测,成本是纯跑公开基准的几十倍。但从「证明能力」的角度,它更有说服力——因为这些题不是从公开题库里来的,模型没法提前见过。
不过还是那句话:委托方是厂商,题目是厂商组织的,结论也只能当参考。真正的第三方验证,得等有人拿自己的任务集去跑。这一点在金蝶灵基的 Lingee Bench那篇里说过——厂商自建基准最大的价值不是排名,是它逼着大家把「怎么算干完了」写清楚。
四、Computer Use 挑 Blender 和 CAD,是在选战场
通用电脑操作这块已经被卷得差不多了。OSWorld 这类基准把「打开浏览器、点按钮、填表单、下载文件」拆成几百个任务,谁都能跑,分数也都能刷。
Hy4 的选择是往专业软件里钻:Blender、CAD,以及跨应用长程任务。这个方向聪明在两点。
一是没人做。通用桌面操作的语料好收集,专业软件的交互路径长、快捷键多、状态复杂,训练数据极难攒。而这类软件恰好是工程设计、制造、游戏、建筑这些行业的日常工具,需求真实存在。
二是它天然是长程任务。在 Blender 里建一个场景,不是一次点击能完成的,中间要几十上百步,还要能看懂视口里的三维状态。这种任务跑通了,说明模型的规划与执行链路真的能拉长,而不只是会点按钮。
代价是能力变成「按软件」的。专项训练意味着换一个软件就得重来一遍,AutoCAD 跑得好不代表 SolidWorks 也行,更不代表你那套自研的 MES 界面能用。所以看到「支持 Computer Use」这句话,正确的问题是:支持哪些软件、什么版本、什么分辨率下的界面,而不是「能不能操作电脑」。
顺带说一句,这类能力对 Agent 产品的意义比对聊天产品大得多。DeepSeek 的 Super-agent 架构里讲的「端侧无状态 Daemon 按需读本地环境」,需要的正是这种能看懂界面、能动手的执行层。
五、安全与开源:只训防守性数据,配 System Card
这次安全部分写得比多数国产发布稿细,值得单独拎出来。
网络安全方面,训练中只纳入与 PoC 生成、漏洞修复相关的防守性数据,剔除漏洞利用、逆向、渗透这类攻击性训练内容。混元组织腾讯玄武和科恩实验室的安全专家,围绕密码分析、逆向工程、漏洞利用做了审计,结论是 Hy4 在这些进攻性能力上未展现突出风险。
生物安全方面,官方给的数字是 Hy-BioExperimentBench 30.4/100,明确说开放式实验设计能力与前沿模型存在明显差距;内部专家审计轨迹后认为,模型基础知识掌握得不错,但把知识转成可执行实验方案的能力有限。
开源方式是近期开放权重,同时发布模型 System Card,重点关注网络和生物安全风险。
这套「限定数据 + 第三方实验室审计 + System Card」的组合,很可能会成为国产开源的默认动作。它解决的不是「模型一定安全」,而是「出了事你能说清楚当时怎么想的、审过什么、边界在哪」。对要采购模型的企业来说,System Card 比发布会 PPT 有用——至少它是一份可以拿去给合规部门看的文件。
六、影响分析:三条线会变
对开发者:多了一个可选的开源旗舰,但自托管的门槛没降。770B 总参数、49B 激活,就算 MoE 稀疏激活省算力,要稳定跑起来仍然是集群级的事。中小团队的现实路径还是 API 或者云上 TokenHub,权重开放更多是给有算力的一方(云厂商、行业集成商、做私有化的公司)用的。
对 Agent 产品:能力差会变成场景差。当模型厂开始为一个具体产品调参,通用 API 之间的「能力差」会逐渐让位给「场景差」——同一个模型在你的产品里可能只有 70 分,在别人的产品里有 90 分。选型不能只看榜单,得拿自己的任务集跑一遍。这也是腾讯 Buddy One那套思路的延续:底座共享、场景各自调。
对国内竞争:这一周三家挤在一起发。据中财网等媒体梳理,同期还有 MiniMax M3.1 Flash(推理速度超 200 TPS)、月之暗面 Kimi K3.1 Pro(参数规模 3 万亿)、科大讯飞星火 X2.6(端侧智能体覆盖率 41.9%)——这几个数字是媒体口径,未必都是官方原文。但方向很清楚:一条线拼参数上限,一条线拼推理效率与成本,一条线拼端侧覆盖。三条线同时推进,说明国产模型不再只在一个维度上比。
七、老达点评
一、96.15% 通过率,看趋势别看绝对。自家产品、自家题、自家判分,这个数字只能证明「比 preview 强很多」,不能证明「在你的场景里也强」。真要参考,去跑自己的二十个任务,比看一百个跑分有用。
二、213 位外部专家这件事,比 770B 更值得学。不是因为数字大,是因为它逼着团队把「什么叫干得好」定义清楚。很多企业做 Agent 做不下去,问题不在于模型不行,而在于从来没写过验收标准。
三、Computer Use 挑专业软件,是聪明的错位竞争。但也意味着能力是按软件绑定的。采购前问清楚支持清单,别指望它明天就能操作你那套没人维护的内部系统。
四、幻觉率 7.2% 是自建测试,别拿去横比。从 12.95% 降下来是真进步,猜测型错误从 23.1% 降到 5.6% 更是实打实的改善。但各家的自建口径不一样,横着比没有意义。要看的是同一家、同一套题、跨版本的走势。
五、对普通团队最有用的信息,其实是那两个时间窗和缓存价。11 月 4 日到 15 日的免费额度,够跑一轮真实任务验证;五折到年底,够做一次成本测算。另外注意缓存命中 0.3 元、输入 6 元——缓存价是输入价的二十分之一,这个比例在明确告诉你:长上下文里重复的前缀,是被鼓励复用的。这和 Claude 的 message threads 是同一个方向的两面,一个省算力钱,一个省上传时间。
八、总结:三点可用
第一,先量自己的请求。如果你的任务里长文档、图片、多轮修改占比高,那视觉理解和长上下文的价值就大;如果主要是短问答和工具调用,770B 跟 300B 对你没差别,Flash 更合适。
第二,把验收标准写下来再选模型。场景分的意义在于提醒你:模型好不好,取决于在什么工作流里、按什么标准判。你自己的那套标准,得自己写。
第三,专业软件场景别急着上。Blender、CAD 这类专项能力确实稀缺,但先确认你的版本、你的插件、你的界面分辨率在不在支持范围内。跑不通的时候,问题往往不在模型,在截图质量和界面状态。
最后一句:这次发布真正的信号,不是开源模型追上了闭源,而是模型厂开始承认「通用能力」和「把活干完」是两件事。承认了,才会去做 Co-Design、才会去找两百个专家出题、才会专门为 Blender 和 CAD 调一遍。这个转向,对整个 Agent 行业都是好事。