先把事情说清楚
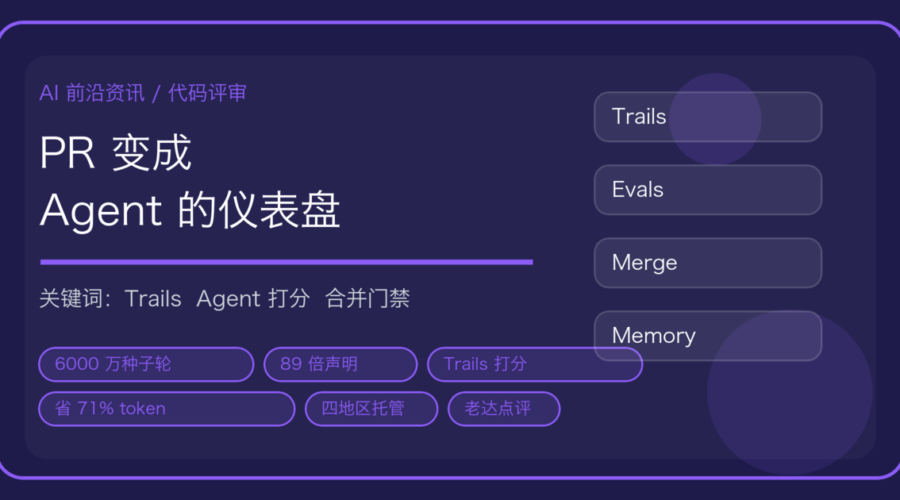
10 月 26 日至 27 日,GitHub 前 CEO Thomas Dohmke 创办的 Entire 正式开放了它的 Git 托管与代码评审服务。这件事的分量不在于「又有一个 GitHub 竞品」,而在于它把代码合并的判据换掉了:Pull Request 变成 Trails,人不再逐行读 diff,而是看多个 Agent 按预设标准打出的分数,分数过关就可以合并。
时间线值得捋一遍:
- 2025 年,Dohmke 离开 GitHub。他在那家公司待了十多年,其中近四年是 CEO。
- 2026 年 2 月,Entire 以 6000 万美元种子轮起步,Felicis 领投,Madrona、Basis Set 和微软的 M12 参与,估值约 3 亿美元。当时代的产品叫 Checkpoints——一个开源 CLI,记录 AI 改动背后的推理过程。
- 2026 年 7 月,开放分布式 Git 网络预览:把 GitHub 上的仓库镜像到美国、欧洲、澳洲等区域节点,让 Agent 就近克隆。厂商自测约 57 万次克隆/小时、586 次推送/秒。
- 2026 年 10 月,原生 Git 托管加评审工作流上线,仓库可以放在美国、印度、澳大利亚、欧盟四个区域,构建测试接 Buildkite 和 Depot。公开仓库与自托管还在路线图上。
背景数据也不复杂:GitHub 8 月出现过一次约 8 小时的故障,9 月单月开发者与 Agent 合计提交 73.8 亿次,平台为此从自有数据中心迁往微软 Azure。Dohmke 在发布会上引了一句话——PR 已经变成「只有 Agent 会读的审计日志」,而评审这个瓶颈「大了十倍」。他自己补了一句更实在的:在软件公司干活,谁没等过别人 review 自己的 PR,还得在群里催三遍。
Trails 到底怎么工作
- 一次 push 之后,多个评审 Agent 按可配置的 eval 标准打分,返回分数、解释和具体发现。
- 发现可以由人修复,也可以让 Agent 自己改,改完再跑一轮,界面上能看到每一轮发现怎么变化。
- 一个 Trail 可以跨多个仓库,把「功能请求或缺陷报告—改动—评审结果」串成一条。
- 可以设门禁:必须人工批准、必须构建与测试通过。评审 Agent 在隔离的云端环境里跑(隔离要做到什么程度,可以看 AI Agent 沙箱要隔离哪四样东西)。
- 每条 Trail 会显示 Agent 消耗了多少 token。这一点比多数评测产品实在——评审也要花钱,花了多少应该能看见。
- 数据通过 Web 界面和开源 CLI 都能访问,所以编码 Agent 可以在循环里自己处理发现,人只看趋势。
另一个功能叫 Continuous Memory:把开发会话的日志、prompt 和代码放在一起,构成「代码库图谱 + agentic brain」,让后续 Agent 检索历史决策。官方说法是最多省 71% 的 token。性能上还有一句更抓眼球的:Git 托管比 GitHub 快 89 倍,比 Cursor 的 Origin 快 6 倍。这两个数字是厂商自测,参考仓库、网络拓扑和并发模型都没披露。
影响一:评审的证据类型换了
过去的评审看的是「代码长什么样」——命名、结构、边界处理、可读性。这套标准成立的前提是评审人有时间把 diff 读完。当 Agent 一天提交几十次,读 diff 这件事在物理上就不成立了。
Trails 换的是另一套判据:行为对不对。标准写成可执行的标准项,由 Agent 跑,输出分数和发现。质量判据从「可读」变成「可测」。这个转变比界面变化重要得多,因为它直接决定了什么样的团队能用、什么样的团队用不了。评测标准怎么设计,可以参考 AI Agent 评测怎么做,那套方法用在代码上一样成立。
影响二:责任没转移,只是更隐蔽了
「分数过绿灯就合并」听起来像放权,实际上是把审查动作从「读」挪到了「写标准」。谁写这些标准项,谁就在决定什么算合格。这件事的危险在于它不可见:diff 至少有行数,标准只有一段配置。
Entire 自己的说明里也留了余地——一个绿色的分数并不保证变更安全、完整或符合公司要求。这句话值得每个打算用的团队打印出来贴墙上。质量门禁该有哪些硬项,AI Agent 质量门禁怎么设 里给过一套清单,核心是「哪些检查必须过」要由人定,不能由工具默认。
影响三:瓶颈从人挪到了配额和算力
分布式 Git 网络这门生意,本质上在卖「Agent 的克隆带宽」。当仓库镜像到区域节点、评审 Agent 在云端跑、每条 Trail 都在烧 token,成本和容量就成了新的管理对象。7 月那次预览之所以要讲 57 万次克隆/小时,是因为它对应一个真实痛点:Agent 集群撞上托管平台的速率限制,团队只能自己做缓存和排队。
国内团队不一定需要换托管,但会撞上同一堵墙:CI 并发、克隆超时、Agent 等待。所以判断要不要跟进这件事,看的不是「GitHub 会不会被替代」,而是「你的 Agent 有多少时间花在等仓库上」。这个数字能测,测出来就有答案。
老达点评
第一,最值得抄的不是 Trails 的界面,是把标准当资产管理。每条 Trail 的评分标准必须版本化、留历史、能 diff。标准一改,等于门槛悄悄变了,昨天的绿灯今天可能是黄灯。没有版本管理的评分标准,三个月后没人说得清「当时凭什么放行」。
第二,「不看 diff 就合并」只在有强测试的仓库成立。判断你能不能用的标准很朴素:你的关键行为有没有可自动验证的断言。有,这套东西能省下大量时间;没有,它只会给你一个虚假的安全感。所以正确顺序是先补测试和标准项,再谈换评审工具——顺序反了,买到的是一个更快的出错通道。
第三,89 倍这种数字别当决策依据。参考仓库、拓扑、并发模型都没公开,这和厂商自己写个 benchmark 没有本质区别。你要看的是自己仓库的克隆耗时、Agent 等待占比、CI 排队时间。这三个数一测,答案自然就出来了。
第四,这件事真正会推动的,是评审记录的形态。以后审计要的东西会变:不是 PR 里那串评论,而是「标准项版本 + 分数 + 谁批准 + 当时跑的是哪个模型」。这个口径现在就该定,因为它是唯一能在半年后复现「当时凭什么放行」的东西。AI Agent 证据包怎么留 讲的是同一件事,只不过对象从对话换成了代码。
还没解决的问题
- 公开仓库与自托管未上线:对不想把代码放到第三方的团队,这就是硬门槛。
- 数据驻留只有四个区域:跨境团队要按项目拆仓库,运维复杂度上升。
- 标准项由谁定:厂商给的是预置项(代码质量、安全、低质量输出),真正贴合业务的标准还得团队自己写,这部分工作量不小。
- Agent 打分的可复现性:模型版本、温度、上下文都会影响分数。同样的改动两次跑出不同分数,门禁就没有意义。这一点厂商没有展开讲。
- 和既有 CI 的边界:接了 Buildkite 和 Depot,但测试失败与评审失败的处置路径怎么分,实际用起来才知道。
另外值得对照的是,开发基础设施这一层今年已经动了两回:Anthropic 把内部主仓库从 Git 迁到自研的 Scion(那件事的复盘在这篇),Entire 则从外部做了一个面向 Agent 的托管与评审产品。一个是往里收,一个是往外扩,指向同一个判断——Agent 提交的代码量已经把「人读 diff」这条路径压断了。
一句话总结
Entire 值得关注的不是它能不能替代 GitHub,而是它把「凭什么合并」这个问题从人的眼睛挪到了可配置的标准上。挪过去之后,效率确实会涨;但标准谁写、版本谁管、绿灯谁签字,这三件事如果没人管,涨的就不只是效率。